Choisir un seul cas d’usage IA rentable et mesurable
Une méthode pour passer d’un catalogue d’outils à un pilote utile, avec trois candidats, une métrique de valeur et une règle d’arrêt.
Sommaire
- Pourquoi le catalogue ne suffit pas
- Choisir trois candidats, pas dix
- Une shortlist utile ressemble à cela
- Le pilote en 30 jours
- Les métriques qui servent vraiment à décider
- Quand arrêter, quand étendre
- Si votre terrain est France et Afrique francophone
- Votre prochaine action
- Sources officielles et liens utiles
Le problème n’est plus d’accéder à l’IA. Le problème est de savoir quoi choisir en premier.
France Num montre que les petites entreprises ne manquent pas d’options : l’État et Hub France IA ont déjà référencé 88 entreprises d’IA pour les PME et les ETI, avec des offres qui vont des copilotes métiers à l’analyse documentaire, en passant par la génération augmentée par récupération et l’automatisation de la relation client vocale. En parallèle, la Banque de France observe encore un écart d’adoption entre les entreprises françaises et leurs pairs de la zone euro, avec des freins plus fréquents du côté des données, de la vie privée et des enjeux éthiques.
La bonne conclusion n’est pas de courir vers le dernier outil à la mode. C’est de choisir un seul cas d’usage, de le cadrer proprement, puis de vérifier qu’il produit une valeur visible.
À la fin de cet article, vous saurez :
- choisir trois candidats crédibles sans vous disperser ;
- éliminer les cas séduisants mais fragiles ;
- lancer un pilote de 30 jours avec reprise humaine ;
- suivre quelques métriques qui servent vraiment à décider ;
- arrêter sans regret si la preuve n’est pas au rendez-vous.
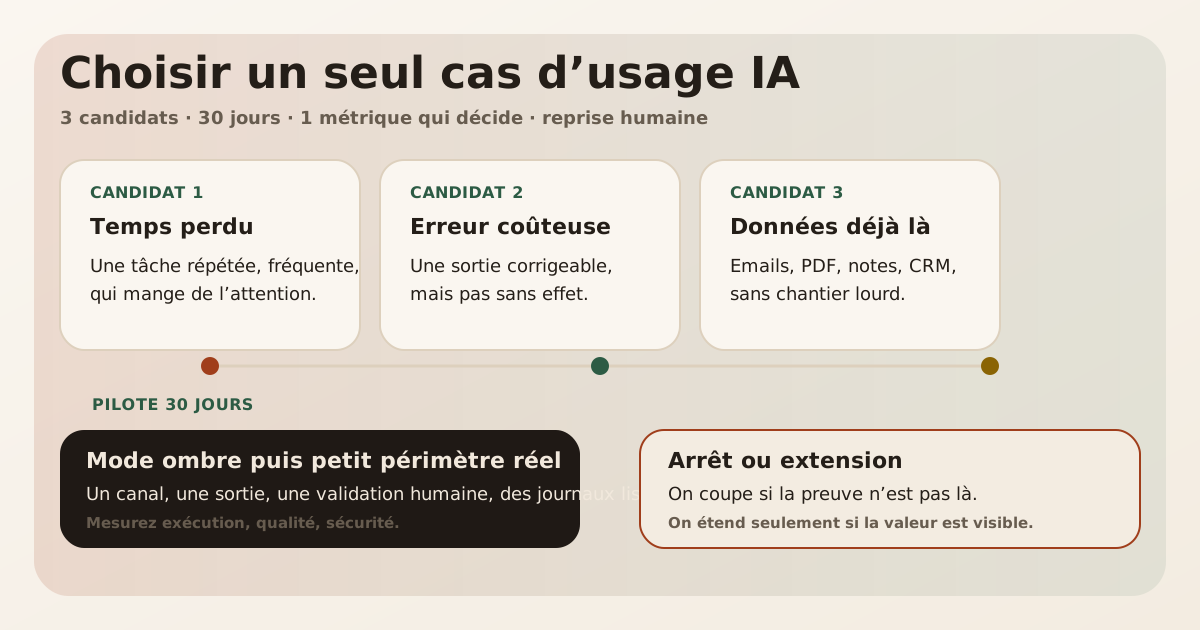
Schéma original BâtisseurIA. Création interne 2026. Copyright BâtisseurIA / Aymane Abdennour. Licence CC BY 4.0.
Pourquoi le catalogue ne suffit pas
Un catalogue répond à une bonne question, mais pas à la vôtre.
La bonne question du catalogue est : « Qu’est-ce qui existe ? » La vôtre est : « Qu’est-ce qui mérite un test chez moi, maintenant ? »
France Num explique que l’IA peut être utilisée sans infrastructure lourde pour des projets modestes, parfois avec un simple navigateur ou un compte déjà existant, et que des données non structurées comme des courriels, des PDF ou des notes peuvent suffire à lancer un projet plus structuré. C’est une bonne nouvelle. Cela signifie que le premier pas n’exige pas de chantier technique gigantesque.
Mais cette accessibilité crée un piège : plus un outil est facile à essayer, plus on risque de le choisir pour sa facilité, pas pour son utilité.
Le meilleur point de départ n’est donc pas le plus impressionnant. C’est le plus répétitif, le plus visible et le plus mesurable.
Choisir trois candidats, pas dix
Avant de parler d’outil, faites une liste courte.
Votre premier filtre doit produire trois candidats maximum. Pas parce que trois est un chiffre magique, mais parce qu’au-delà vous commencez à comparer des hypothèses qui ne sont déjà plus homogènes.
Pour chaque candidat, posez trois questions simples.
1. Est-ce que ce travail fait perdre du temps ?
Cherchez les tâches qui reviennent souvent, prennent du temps et ne demandent pas toujours un jugement complexe.
Exemples typiques :
- rédiger un premier brouillon de réponse ;
- classer des demandes entrantes ;
- résumer un compte rendu ;
- extraire des champs d’un document ;
- préparer une note de suivi à partir de plusieurs sources ;
- reformuler un message commercial ou administratif.
Le bon signal n’est pas « c’est pénible ». Le bon signal est « on le refait souvent, avec la même structure, et cela mange de l’énergie humaine ».
2. Est-ce qu’une erreur coûte quelque chose ?
Une erreur n’interdit pas forcément le projet. Elle change seulement le niveau de prudence.
Si l’erreur est facilement corrigible, le cas d’usage reste candidat. Si elle peut toucher un paiement, un contrat, une décision RH, des données sensibles ou un client exposé, le cas devient plus risqué et doit garder une validation humaine forte.
En pratique, un bon premier cas d’usage est souvent un cas où l’erreur :
- se voit vite ;
- se corrige vite ;
- n’engage pas l’entreprise trop loin ;
- n’abîme pas la relation avec un client ou un partenaire.
3. Est-ce que les données sont déjà là ?
France Num insiste sur un point utile : beaucoup de petits projets IA peuvent démarrer à partir de données déjà disponibles, sans nouvelle infrastructure lourde.
Votre cas d’usage est plus crédible si les données existent déjà dans :
- des emails ;
- des PDF ;
- des notes internes ;
- un CRM ;
- des fichiers partagés ;
- une base documentaire simple.
Si vous devez d’abord nettoyer six mois de données ou connecter trois systèmes peu stables, vous n’êtes peut-être pas devant un premier cas d’usage. Vous êtes peut-être devant un projet d’infrastructure.
Une shortlist utile ressemble à cela
Voici un exemple de sélection raisonnable pour une petite équipe.
- Cas A : préparer un brouillon de réponse pour des demandes répétitives.
- Cas B : extraire des champs d’un document qui revient souvent.
- Cas C : résumer et orienter un lot de notes ou de comptes rendus.
Ces trois cas ont un point commun : ils sont utiles, ils se testent vite, et ils permettent d’observer l’IA sans lui donner tout le pouvoir.
Ils ont aussi une différence importante :
- le premier améliore la vitesse de réponse ;
- le deuxième améliore la qualité de saisie ou de classement ;
- le troisième améliore le temps de lecture et de décision.
Si vous hésitez entre plusieurs candidats, choisissez d’abord celui qui touche le plus souvent un flux réel. Un cas d’usage rare mais spectaculaire se défend mal face à un cas banal mais répété tous les jours.
Le pilote en 30 jours
Le but d’un pilote n’est pas de prouver que l’IA est « bonne ».
Le but est de savoir si elle aide ce travail précis, dans ce contexte précis, avec ce niveau de risque précis.
Je vous conseille une fenêtre de 30 jours, découpée en quatre temps.
Semaine 1 : définir le périmètre
Écrivez une phrase simple :
Nous voulons utiliser l’IA pour [action], sur [flux], avec [équipe], afin d’obtenir [résultat].
Puis fixez quatre bornes :
- un seul canal d’entrée ;
- un seul type de sortie ;
- une seule équipe propriétaire ;
- une seule voie d’escalade humaine.
Plus le périmètre est petit, plus la preuve est lisible.
Semaine 2 : tester en mode ombre
Le mode ombre consiste à laisser l’outil travailler sans lui confier l’action finale.
Il peut :
- classer ;
- proposer ;
- résumer ;
- préparer un brouillon ;
- signaler qu’il manque une information.
Mais un humain garde la dernière main.
Ce mode est précieux parce qu’il vous montre la qualité réelle sans vous exposer immédiatement aux conséquences d’une mauvaise sortie. C’est aussi le bon endroit pour voir si la solution tient quand les cas sont un peu sales, un peu flous ou un peu incomplets.
Semaine 3 : ouvrir un petit périmètre réel
Si le mode ombre est stable, ouvrez une production limitée.
Gardez :
- un volume plafonné ;
- une validation humaine ;
- des journaux lisibles ;
- une manière simple de revenir en arrière ;
- un propriétaire nommé.
Si la solution demande trop d’accès, trop de mémoire ou trop de données avant d’avoir prouvé sa valeur, la réponse est souvent non, ou plus tard.
Semaine 4 : décider
À la fin des 30 jours, vous avez trois options :
- arrêter ;
- corriger ;
- étendre.
Ne gardez pas un pilote « parce qu’on a déjà commencé ». Gardez-le parce qu’il a produit une amélioration observable.
Les métriques qui servent vraiment à décider
n8n recommande de suivre des métriques qui changent une décision, en les regroupant autour de l’exécution, de la qualité, de l’efficacité et de la sécurité. C’est exactement la bonne logique pour un premier cas d’usage.
Je vous conseille de rester simple.
Exécution
Mesurez si le système fait vraiment ce qu’on lui demande.
- nombre de cas traités ;
- délai de traitement ;
- taux de complétion ;
- taux d’escalade vers un humain.
Qualité
Mesurez si la sortie est exploitable.
- part des sorties corrigées par un humain ;
- nombre d’erreurs factuelles ;
- conformité au format attendu ;
- clarté du brouillon produit.
Sécurité
Mesurez si l’outil reste dans ses limites.
- type de données exposées ;
- permissions réellement utilisées ;
- nombre d’actions non autorisées ou à bloquer ;
- incidents ou tentatives de sortie du périmètre.
Une seule métrique de valeur doit décider si le pilote gagne du terrain. Par exemple :
- temps moyen avant première réponse ;
- temps moyen avant décision ;
- nombre de documents traités par heure ;
- réduction des corrections manuelles.
Si aucune métrique ne bouge, le pilote ne prouve rien. Si une métrique bouge mais que la sécurité ou la qualité se dégrade, le pilote ne mérite pas d’extension.
Quand arrêter, quand étendre
Arrêtez si l’un de ces signaux apparaît :
- une erreur critique survient ;
- la validation humaine devient une illusion ;
- les permissions deviennent trop larges ;
- les journaux ne permettent plus d’expliquer ce qui s’est passé ;
- la valeur métier reste invisible après la période test.
Étendez seulement si :
- le gain est visible ;
- les exceptions sont connues ;
- le coût de supervision reste supportable ;
- l’équipe comprend ce que le système fait et ce qu’il ne fait pas.
La Banque de France rappelle que les entreprises françaises citent plus souvent les données, la vie privée et l’éthique comme freins à l’adoption de l’IA. Votre pilote doit donc être lisible sur ces trois points. On ne gagne pas en confiance en restant flou.
Si votre terrain est France et Afrique francophone
Le même cas d’usage ne se déploie pas de la même façon partout.
Le World Bank Digital Progress and Trends Report 2025 insiste sur les contraintes d’infrastructure, de données et de compétences qui pèsent sur l’adoption de l’IA dans les pays à revenu faible et intermédiaire. Le rapport souligne aussi l’intérêt des solutions de type « Small AI », plus légères et plus accessibles sur des appareils courants.
UNESCO ajoute un point décisif : les cadres de compétences et les ressources en langues locales comptent pour l’inclusion. Si votre usage vise des équipes ou des publics en Afrique francophone, il faut tester :
- le français simple ;
- le français administratif ;
- les mélanges de langues habituels ;
- le comportement sur mobile ;
- le comportement avec une connexion irrégulière ;
- la reprise humaine quand le système échoue.
Ce n’est pas un détail exotique. C’est souvent la différence entre un pilote réaliste et un pilote hors-sol.
Votre prochaine action
Si vous ne savez pas quoi faire ce matin, faites ceci :
- écrivez le résultat concret que vous voulez obtenir ;
- listez trois cas d’usage candidats ;
- éliminez ceux qui n’ont ni données, ni propriétaire, ni métrique ;
- choisissez un seul pilote de 30 jours ;
- notez la métrique qui décidera de la suite ;
- gardez une voie d’arrêt claire.
Si vous avez déjà un flux à cadrer, l’article Avant d’adopter une solution IA, exigez trois preuves vous aide à tester la solution avant d’investir. Si votre priorité est encore la file d’attente et la réponse aux demandes entrantes, Visibilité, réponse, mesure reste un bon complément. Et si vous devez aller plus loin dans la délégation, la fiche de délégation d’un agent IA et l’article sur l’identité, le sandbox et l’approbation avant production donnent le cadre suivant.
Sources officielles et liens utiles
- France Num, Osez l’IA dans votre TPE PME
- France Num, Solutions d’IA pour PME et ETI
- France Num, Baromètre France Num 2025
- Banque de France, An AI Adoption Gap Among French Firms?
- n8n, AI agent observability
- n8n, AI agent performance metrics
- World Bank, Digital Progress and Trends Report 2025: AI Foundations
- UNESCO, AI competency frameworks and local language learning in Africa
Dernière vérification des sources : 21 août 2026. Cet article donne une méthode de décision et de cadrage, pas un avis juridique ou un audit de conformité.