Agent IA en production : identité dédiée, sandbox et approbation avant le premier outil
Une méthode pratique pour réduire les droits d’un agent, isoler son exécution et valider les actions irréversibles avant mise en production.
Sommaire
- Le vrai problème n’est pas le modèle, c’est la frontière
- Trois frontières à écrire noir sur blanc
- Un exemple concret : tri de support sans pouvoir excessif
- Comment le traduire dans n8n, OpenClaw ou un autre orchestrateur
- La check-list de mise en production
- Les erreurs les plus fréquentes
- Ce que cette méthode ne garantit pas
- Le minimum à écrire aujourd’hui
- Sources officielles
Un agent utile n’a pas seulement besoin d’un bon prompt. Il a besoin d’une frontière claire entre ce qu’il peut comprendre, ce qu’il peut toucher et ce qu’il n’a pas le droit de faire sans validation.
La plupart des prototypes échouent au même endroit. On leur donne des droits trop larges, un contexte trop long, une mémoire trop persistante et une route trop directe vers des systèmes réels. Le résultat peut sembler fluide pendant une démo, puis devenir impossible à auditer dès qu’un ticket, un mail ou une API dérive de la trajectoire prévue.
Si tu as déjà rempli la fiche de délégation en 7 décisions, cet article prend la suite logique. La fiche dit quoi déléguer. Ici, on voit comment mettre l’agent en production sans lui confier davantage de pouvoir que nécessaire.
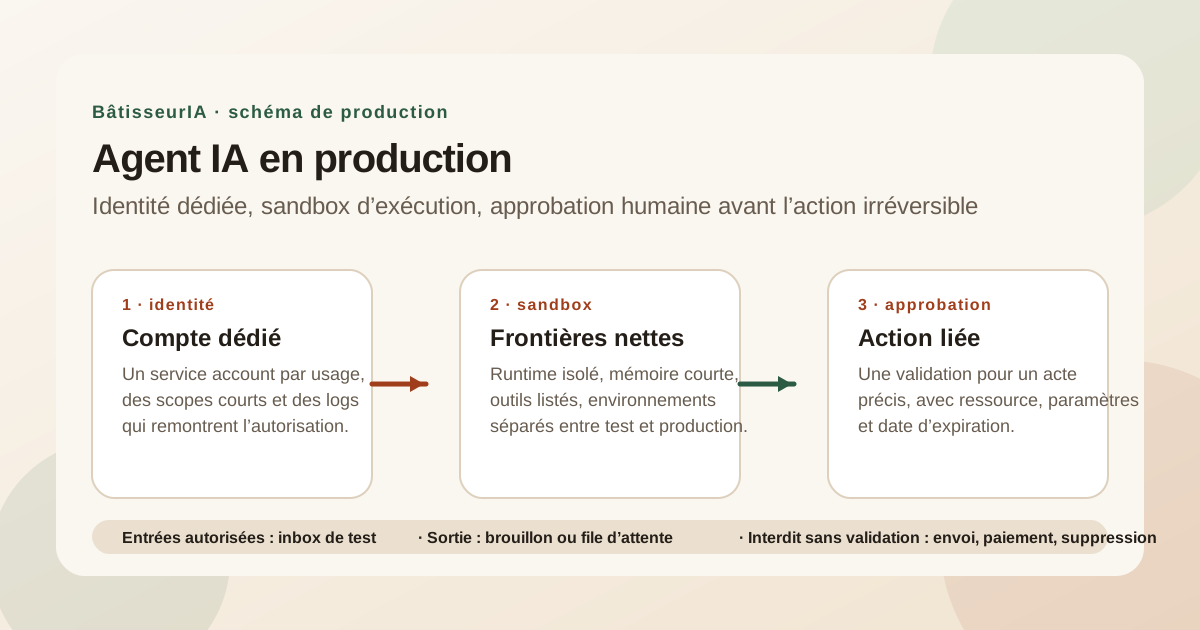
Schéma original BâtisseurIA, création interne 2026. Copyright BâtisseurIA / Aymane Abdennour. Licence : tous droits réservés.
À la fin de la lecture, tu sauras :
- écrire l’identité d’exécution d’un agent sans la confondre avec celle d’un utilisateur humain ;
- limiter ce qu’il peut voir, appeler, retenir et modifier ;
- faire valider les actions à risque avant qu’elles ne partent ;
- repérer les signaux qui imposent de couper le flux plutôt que de l’optimiser.
Le vrai problème n’est pas le modèle, c’est la frontière
Les modèles d’IA savent produire un résultat plausible. Ce qu’ils ne savent pas garantir, c’est la stabilité d’un chemin d’exécution lorsque le contexte change. C’est là que l’agent devient un sujet de sécurité, pas seulement de qualité.
Le blog n8n le dit très clairement dans son article sur l’identité des agents : les modèles IAM classiques supposent souvent un humain derrière le clavier, alors qu’un agent peut enchaîner plusieurs API en quelques secondes, avec un audit trail qui n’explique plus qui a réellement autorisé quoi. La page de NIST sur l’AI Agent Standards Initiative va dans le même sens en visant des agents « trusted, interoperable and secure » qui fonctionnent de manière sûre au nom des utilisateurs. OWASP, de son côté, demande d’appliquer le moindre privilège, d’isoler mémoire et contexte et de placer un humain dans la boucle pour les actions à risque.
Le point commun est simple : un agent ne doit pas hériter d’une liberté vague. Il doit recevoir une permission bornée, pour une tâche bornée, dans un environnement borné.
Autrement dit, le bon design ne commence pas par « quel outil brancher ? ». Il commence par « que peut-il faire, sur quoi, pendant combien de temps, et qui doit dire oui avant les actions irréversibles ? »
Trois frontières à écrire noir sur blanc
1. L’identité
Une identité d’agent n’est pas un compte humain recyclé.
Dans l’article n8n sur l’identité des agents, l’idée centrale est de séparer l’authentification de l’autorisation, de donner des scopes étroits et de faire remonter l’identité d’origine dans les journaux. C’est la base pour savoir quel agent a agi, sur quel workflow, avec quelle version et sous quelle autorisation.
Concrètement, l’identité d’un agent doit répondre à cinq questions :
- quel service account ou quelle identité technique l’agent présente-t-il aux systèmes externes ;
- quel utilisateur ou quelle session a autorisé l’exécution ;
- quelle durée de vie a l’accès ;
- quelles ressources sont dans le périmètre ;
- quelles traces permettent de reconstituer la décision.
Le piège classique consiste à laisser un token durable, partagé entre plusieurs workflows, puis à espérer que les logs suffiront à comprendre l’incident. Ils ne suffisent pas.
Pour une production saine, préfère :
- un compte dédié par usage ou par famille d’usage ;
- des credentials séparés entre test, préproduction et production ;
- des scopes étroits ;
- des accès temporaires lorsque c’est possible ;
- un journal qui indique à la fois l’action et le contexte d’autorisation.
2. Le sandbox
Le sandbox ne se réduit pas à « faire tourner le code ailleurs ».
L’article n8n consacré aux sandboxes rappelle qu’il faut encadrer ce que l’agent peut faire, où il peut le faire et quelles informations il peut transporter avec lui. Cela recouvre l’exécution, les outils, la mémoire et les systèmes externes.
Un sandbox utile doit donc limiter au moins quatre choses :
- le runtime, pour éviter qu’un agent improvisé touche le même espace que la production ;
- les outils, pour qu’un appel non prévu soit refusé ;
- la mémoire, pour qu’un contexte d’un client ou d’un workflow ne déborde pas sur un autre ;
- l’environnement, pour séparer développement, test, préproduction et réel.
n8n documente aussi des task runners pour exécuter des tâches de manière sécurisée et performante, ainsi qu’un système de rôles et permissions pour cadrer qui peut faire quoi. Ce genre de brique n’a d’intérêt que si on l’utilise pour réduire la surface d’attaque, pas pour déplacer le risque d’un dossier à un autre.
En pratique, un sandbox bien pensé répond à une seule question utile : si l’agent est trompé, qu’est-ce qu’il est encore physiquement capable de casser ?
3. L’approbation
Le troisième mur est humain.
OWASP recommande de mettre un humain dans la boucle pour les actions à haut risque. Cela ne veut pas dire valider tout et n’importe quoi. Cela veut dire lier l’approbation à une action précise, avec des paramètres précis.
Une bonne approbation contient au minimum :
- l’acteur ;
- l’outil ou le système cible ;
- la ressource visée ;
- les paramètres normalisés ;
- l’horodatage ;
- une date d’expiration ;
- un retour d’état exploitable par le workflow.
Cette granularité est importante. Si tu demandes seulement « veux-tu continuer ? », tu obtiens un oui de confort. Si tu montres exactement ce qui va être envoyé, modifié ou supprimé, tu obtiens une vraie décision.
L’approbation doit bloquer par défaut les opérations irréversibles :
- envoi de message externe ;
- création ou suppression d’enregistrement ;
- changement de permissions ;
- paiement ;
- publication ;
- déploiement en production.
Si l’étape d’approbation, la politique de risque ou le journal d’audit échoue, le workflow doit échouer fermé.
Un exemple concret : tri de support sans pouvoir excessif
Imaginons un agent chargé d’aider une petite équipe support.
Son travail utile est simple :
- lire un message entrant ;
- reconnaître la catégorie probable ;
- préparer un brouillon de réponse ;
- demander validation ;
- seulement ensuite, envoyer ou classer selon le verdict humain.
Ce que l’agent ne doit pas faire :
- modifier seul le compte client ;
- fermer un ticket sans approbation ;
- supprimer une pièce jointe ;
- déclencher un remboursement ;
- réécrire la base CRM avec une valeur qu’il n’a pas vérifiée.
Dans ce cas, l’architecture minimale ressemble à ceci :
- Entrée : boîte mail ou file de tickets en lecture seule ;
- Analyse : modèle ou agent dans un environnement isolé ;
- Mémoire : contexte court, réinitialisé par ticket ;
- Sortie : brouillon, catégorie, proposition d’action ;
- Validation : humain qui confirme, corrige ou refuse ;
- Action : seule la tâche validée passe dans le système métier ;
- Journal : horodatage, version du flux, décision, raison et action finale.
Cette architecture est volontairement moins spectaculaire qu’un agent qui « fait tout ». Elle est aussi beaucoup plus survivable en production.
Comment le traduire dans n8n, OpenClaw ou un autre orchestrateur
Le nom de l’outil change moins que la structure.
Que tu passes par n8n, OpenClaw ou un autre orchestrateur, la même logique reste valable :
- Créer une identité dédiée pour le workflow.
- Retirer les permissions inutiles avant tout test.
- Séparer les environnements au lieu de réutiliser la même clé partout.
- Éviter les secrets en dur dans le flux ou dans l’export.
- Journaliser la décision autant que l’exécution.
- Mettre le point d’arrêt avant l’action irréversible.
Dans n8n, cela se traduit très bien par une combinaison de rôles, de partage de workflow, de credentials séparés et de task runners pour les tâches sensibles. Le message à retenir n’est pas « n8n est sécurisé par défaut ». Le message est plutôt : si tu n’utilises pas ses frontières, tu récupères juste une belle interface avec les mêmes vieux risques.
La logique s’applique aussi aux systèmes plus légers :
- un script qui lit une API ne doit pas recevoir l’accès en écriture juste parce que c’est plus simple ;
- un agent de brouillon ne doit pas disposer des mêmes permissions qu’un agent de publication ;
- un environnement de test ne doit pas contenir des clés de production ;
- un historique d’exécution ne doit pas devenir une mémoire persistante de toute l’organisation.
La check-list de mise en production
Avant de laisser un agent toucher un système réel, vérifie ces points :
- l’identité de l’agent est distincte de celle d’un humain ;
- les credentials sont séparés par environnement ;
- les outils autorisés sont explicitement listés ;
- les données visibles sont minimisées ;
- les écritures sont bloquées tant que l’étape d’approbation n’est pas passée ;
- les actions irréversibles demandent un vrai consentement humain ;
- le journal permet de reconstruire la chaîne complète ;
- une coupure simple permet d’arrêter le flux ;
- un cas d’échec renvoie au manuel sans perdre la trace ;
- une revue périodique réévalue les permissions et la mémoire.
Si tu ne peux pas cocher l’un de ces points, ne compense pas avec un meilleur prompt. Réduis plutôt le périmètre.
Tu peux aussi reprendre la méthode de De l’idée au système pour passer de la démo à la capacité, puis utiliser la page Automatisation pour cadrer ce qui mérite réellement d’être automatisé.
Les erreurs les plus fréquentes
La première erreur consiste à partager un compte de service entre plusieurs agents « pour aller plus vite ». C’est presque toujours le début d’un audit impossible.
La deuxième erreur consiste à donner à l’agent la même vue que l’utilisateur humain, puis à lui demander d’être prudent tout seul. La prudence n’est pas une permission.
La troisième erreur consiste à croire qu’une sandbox suffit. Si les permissions sont larges, si la mémoire fuit ou si les sorties sont reliées directement à des actions irréversibles, le problème reste entier.
La quatrième erreur consiste à ne rien journaliser de lisible. Un log brut de requêtes et de réponses n’explique pas une décision. Il faut aussi le contexte, la règle appliquée et le verdict humain.
La cinquième erreur consiste à confondre test de qualité et test de sécurité. Une bonne réponse n’est pas forcément une exécution sûre.
Ce que cette méthode ne garantit pas
Cette approche ne remplace pas un audit sécurité, une analyse juridique, un contrôle de conformité ou un examen d’architecture sérieux. Elle ne rend pas un agent « sûr » par magie.
Elle ne protège pas non plus contre tous les scénarios de prompt injection, d’erreur de modèle ou de changement de fournisseur. Elle réduit surtout l’impact d’une erreur en limitant ce que l’agent peut atteindre.
Elle fonctionne d’autant mieux que tu acceptes une règle simple : si une action a un effet durable, elle mérite une autorisation expresse ou une exécution humaine.
Le minimum à écrire aujourd’hui
Prends un seul workflow et écris ces sept lignes :
- son identité d’exécution ;
- ses données visibles ;
- ses outils autorisés ;
- ses actions interdites ;
- son point d’approbation ;
- ses journaux de preuve ;
- son bouton d’arrêt.
Si une ligne reste floue, le workflow n’est pas encore prêt. C’est une bonne nouvelle, parce que tu viens d’éviter de construire un agent qui sait beaucoup faire sans savoir jusqu’où il peut aller.
Le meilleur agent de production n’est pas celui qui agit le plus. C’est celui qu’on peut arrêter, relire et expliquer sans improvisation.
Sources officielles
- n8n, AI Agent Identity Management for Production, 31 juillet 2026
- n8n, AI Agent Sandboxes: A Guide to Isolation and Secure Execution, 6 août 2026
- n8n Docs, Set up task runners
- n8n Docs, Set permissions and roles (RBAC)
- n8n Docs, Share with others
- NIST, AI Agent Standards Initiative
- OWASP, AI Agent Security Cheat Sheet
Sources vérifiées le 12 août 2026. Article de méthode générale, pas un avis juridique ou un audit de sécurité. Révision prévue si les recommandations officielles ou les docs produit évoluent.