Automatisation IA : le runbook de reprise à écrire avant le premier incident
Une méthode en 8 décisions pour détecter, geler, reprendre et améliorer une automatisation IA quand une donnée, un outil ou une sortie devient douteuse.
Sommaire
Une automatisation peut fonctionner pendant des semaines, puis produire une mauvaise sortie au pire moment : un document classé dans le mauvais dossier, une réponse préparée avec une donnée périmée, un outil externe indisponible ou une action déclenchée deux fois.
Le réflexe courant consiste à chercher la cause technique. C’est nécessaire, mais ce n’est pas la première décision à prendre. Pendant l’incident, quelqu’un doit surtout savoir quoi arrêter, quelle preuve conserver, qui reprend le dossier et comment revenir à une procédure manuelle.
Un runbook de reprise est cette fiche opérationnelle. Il ne remplace ni les tests, ni la sécurité, ni la supervision. Il donne une séquence commune lorsque le système ne se comporte plus comme prévu.
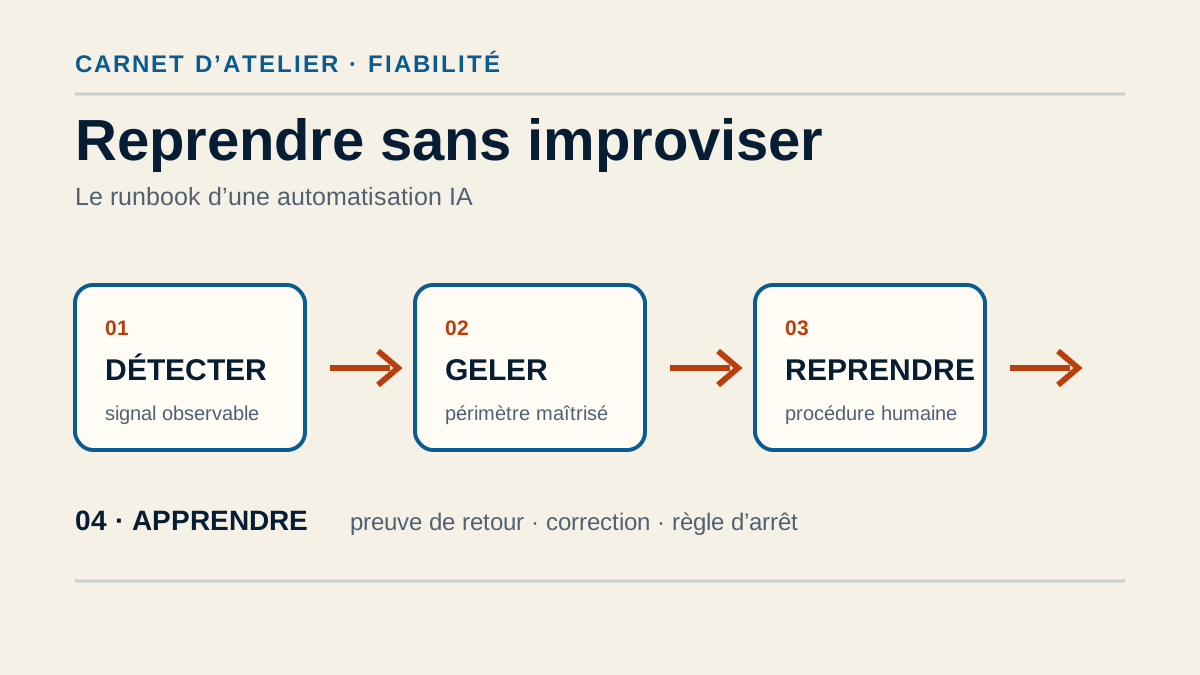
Schéma original BâtisseurIA, création interne 2026. Copyright BâtisseurIA / Aymane Abdennour. Licence : tous droits réservés.
À la fin de cet article, vous aurez une trame pour écrire ce runbook en moins d’une heure sur un seul processus, avec une règle d’arrêt testable et une reprise humaine réellement praticable.
Pourquoi la reprise mérite un document séparé
Un guide de conception explique comment construire un workflow. Un tableau de bord montre son état. Un runbook répond à une question différente : que faisons-nous maintenant que le comportement attendu n’est plus fiable ?
Le NIST AI Risk Management Framework recommande de prévoir après le déploiement la surveillance, l’intervention humaine, la désactivation, la réponse aux incidents, la récupération et la gestion du changement. La CNIL insiste aussi sur la journalisation des actions et sur la nécessité de repérer les comportements anormaux sans exposer inutilement les données des personnes.
Google SRE ajoute une leçon très concrète : une réponse structurée réduit le chaos si les rôles, la communication et le journal de travail sont définis avant l’incident. Cette logique vaut aussi pour une petite équipe. Vous n’avez peut-être pas une astreinte, mais vous avez tout de même besoin d’un propriétaire et d’une sortie de secours.
Le runbook n’est donc pas une promesse de disponibilité. C’est un mécanisme de réduction du dommage et du temps de décision.
Le résultat lecteur : reprendre un dossier sans improviser
Prenons un exemple fictif : une automatisation reçoit des demandes entrantes, extrait quelques champs, propose une catégorie et prépare une réponse. Elle ne doit pas envoyer le message seule. Une personne vérifie la sortie avant l’envoi.
Le runbook doit permettre de répondre à huit questions :
- Quel signal déclenche l’incident ?
- Quelle action est immédiatement gelée ?
- Quelle version du flux était active ?
- Quelles données ou quels dossiers sont concernés ?
- Qui reprend la décision ?
- Quelle procédure manuelle s’applique ?
- Quelle preuve permet de confirmer le retour à la normale ?
- Quelle correction entre dans le backlog ?
Si ces réponses sont dispersées entre un prompt, un outil et la mémoire d’une seule personne, l’équipe n’a pas encore de runbook. Elle a des fragments de connaissance difficiles à utiliser sous pression.
Les 8 décisions à écrire
1. Décrire le comportement qui déclenche l’arrêt
Évitez « si l’IA se trompe ». Cette phrase est trop vague pour guider une action.
Écrivez plutôt des signaux observables :
- une sortie cite un document absent du corpus ;
- un champ obligatoire est vide ou contradictoire ;
- le même identifiant est traité deux fois ;
- un outil externe ne répond plus dans le délai prévu ;
- le taux de reprise humaine dépasse le seuil défini pendant deux périodes consécutives ;
- une personne signale une sortie dangereuse ou manifestement hors sujet.
Le signal doit être relié à une action. « Toute sortie sans preuve bloque l’envoi » est une règle exploitable. « L’équipe reste attentive » ne l’est pas.
2. Geler le bon périmètre
Arrêter tout le système peut créer un autre problème. Ne rien arrêter peut laisser passer des actions risquées.
Définissez trois niveaux :
- pause d’une tâche : le dossier suspect passe en reprise humaine ;
- pause d’une branche : les demandes d’un type donné sont traitées manuellement ;
- pause globale : aucune nouvelle exécution n’est autorisée jusqu’au contrôle.
La consigne doit indiquer qui peut déclencher chaque niveau et comment le vérifier. Un bouton d’arrêt qui existe mais dont personne ne connaît l’emplacement n’est pas un contrôle fiable.
3. Conserver juste assez de preuves
La reprise ne doit pas commencer par une collecte désordonnée de données sensibles. Notez le minimum nécessaire pour reconstruire le chemin :
- identifiant du dossier et heure de l’événement ;
- version du workflow, du prompt ou de la règle active ;
- étape atteinte et outil appelé ;
- signal qui a déclenché l’arrêt ;
- sortie produite et décision humaine ;
- statut final du dossier.
OpenTelemetry distingue notamment traces, métriques et logs : la trace suit le chemin d’une requête, la métrique mesure une tendance, le log enregistre un événement. Vous n’avez pas besoin d’installer toute une plateforme pour appliquer l’idée. Commencez par rendre ces trois angles lisibles dans un tableau ou un export.
Ne recopiez pas le contenu complet d’un dossier dans chaque journal. Masquez les données inutiles, limitez les accès et fixez une durée de conservation cohérente avec le processus.
4. Nommer le propriétaire de la reprise
Un incident sans propriétaire devient une conversation sans décision. Le rôle peut être tenu par une seule personne dans une petite structure, mais il doit être explicite.
Le propriétaire de la reprise :
- confirme la pause ;
- délimite les dossiers affectés ;
- choisit la procédure manuelle ;
- décide si une sortie peut être corrigée ou doit être recréée ;
- clôture l’incident avec une preuve.
Si une communication vers un client, un fournisseur ou un partenaire est nécessaire, indiquez aussi qui la prépare. La personne qui enquête techniquement ne devrait pas être automatiquement la seule à décider de l’impact métier.
5. Décrire la procédure manuelle en peu d’étapes
La reprise humaine doit être réaliste un jour chargé. Écrivez une séquence courte, par exemple :
- ouvrir le dossier original ;
- vérifier les trois champs critiques ;
- comparer avec la source de référence ;
- classer le dossier dans la file « à revoir » ;
- valider ou corriger la sortie ;
- noter la décision et l’heure.
Ne promettez pas que la procédure manuelle reproduira exactement la vitesse du flux automatisé. Son rôle premier est de préserver la qualité, la traçabilité et la continuité.
Pour un processus entre la France et l’Afrique francophone, documentez les dépendances locales au lieu d’écrire une règle générale. Un outil de paiement, une plateforme agréée, une connexion ou un référentiel comptable peuvent changer la procédure de reprise. Le principe commun reste la conservation de l’original, de la décision et de la preuve, pas le choix d’un connecteur universel.
6. Poser une règle de retour, pas seulement une règle d’arrêt
Après une correction, ne relancez pas immédiatement tout le volume. Définissez un retour progressif :
- vérifier la cause supposée sur un cas isolé ;
- rejouer un petit jeu de cas normaux et limites ;
- comparer la sortie à la référence humaine ;
- ouvrir une branche ou un petit volume ;
- surveiller les signaux pendant une période définie ;
- élargir seulement si les critères sont remplis.
La preuve de retour doit être observable. « Le système semble stable » ne suffit pas. Notez par exemple le nombre de cas rejoués, les erreurs critiques, les reprises humaines et la version remise en service.
7. Prévoir l’escalade
Tous les incidents ne méritent pas le même niveau de réponse. Créez une échelle simple :
- niveau 1 : une sortie douteuse, aucun envoi ni changement externe ; correction locale ;
- niveau 2 : plusieurs dossiers affectés ou une branche arrêtée ; propriétaire métier informé ;
- niveau 3 : données sensibles exposées, action irréversible ou impact externe ; arrêt global, responsable désigné et analyse formelle.
Cette gradation évite deux erreurs opposées : banaliser une exposition de données et transformer chaque erreur bénigne en crise générale.
8. Fermer l’incident par une décision
La clôture ne consiste pas seulement à relancer le flux. Elle doit trancher : continuer, corriger, réduire le périmètre, documenter une limite ou arrêter.
Ajoutez quatre champs au compte rendu :
- cause supposée et preuve disponible ;
- dommage évité ou constaté, sans inventer un chiffre ;
- correction décidée, avec propriétaire et échéance ;
- condition qui rouvrirait l’incident.
NIST recommande de suivre les incidents, les erreurs, la récupération et l’amélioration continue. Google SRE recommande également de transformer les enseignements du postmortem en actions suivies dans le backlog. Une correction qui n’a aucun propriétaire n’est pas une correction planifiée.
La fiche à remplir en 45 minutes
Choisissez un seul workflow et copiez cette structure dans un document partagé :
Nom du flux :
Résultat attendu :
Propriétaire de reprise :

Déclencheurs d’arrêt :
Niveau de pause par déclencheur :
Bouton ou action de gel :

Données minimales à conserver :
Procédure manuelle :
Cas qui exigent une escalade :

Critères de test avant reprise :
Volume de reprise progressive :
Preuve de retour à la normale :

Décision de clôture :
Action de correction, propriétaire, échéance :
Testez ensuite la fiche avec un scénario volontairement banal : l’outil externe ne répond plus. Si la personne de reprise doit vous appeler pour comprendre où trouver le dossier, le document n’est pas terminé. Réduisez le nombre d’étapes ou ajoutez le lien exact vers la file manuelle.
Les limites à garder visibles
Un runbook ne rend pas une sortie IA correcte. Il ne remplace pas un jeu de tests, une gestion des accès, un contrôle de qualité ou une analyse juridique. Il ne permet pas non plus de garantir qu’un incident sera détecté immédiatement.
Il y a aussi un risque de faux confort : une fiche très complète peut devenir obsolète après un changement de fournisseur, de branche, de permission ou de procédure métier. Révisez-la après chaque modification importante et faites-la exécuter par une personne qui ne l’a pas écrite.
Enfin, ne journalisez pas davantage simplement parce que c’est possible. La CNIL rappelle que la traçabilité doit rester compatible avec la protection de la vie privée. La bonne question n’est pas « pouvons-nous tout conserver ? », mais « quelle preuve est nécessaire pour décider et expliquer ? »
Votre prochaine action
Prenez l’automatisation la plus utile mais pas la plus risquée de votre activité. Écrivez ses trois déclencheurs d’arrêt, son propriétaire de reprise et sa procédure manuelle. Faites un exercice de dix minutes, sans attendre un incident réel.
Si vous devez encore choisir le niveau d’autonomie, commencez par le guide Assistant, workflow ou agent IA. Si le flux existe déjà, consultez Agent IA : évaluer et observer avant de l’étendre et Agent IA en production : identité dédiée, sandbox et approbation. Pour partager un cas concret et confronter vos hypothèses, vous pouvez aussi découvrir la communauté.
Sources officielles et liens utiles
- NIST AI RMF Core, Govern, Map, Measure et Manage : rôles, supervision humaine, surveillance après déploiement, réponse et récupération.
- CNIL, Sécuriser le traitement : journalisation, comportements anormaux et maîtrise des accès.
- CNIL, Utiliser un système d’IA en production : supervision, qualité des sorties, transparence et protection de la vie privée.
- OpenTelemetry, Signals : distinction entre traces, métriques et logs, page mise à jour le 10 mars 2026.
- Google SRE, Incident Response : rôles, coordination, journal de travail, déclaration précoce et entraînement.
- Google, Incident Management Guide : préparation, postmortem et suivi des actions correctives.