Agent IA : évaluer et observer avant de l’étendre
Une méthode pour bâtir un banc d’essai, lire les traces, suivre les métriques et éviter de découvrir les échecs en production.
Sommaire
- Pourquoi une démo ne suffit pas
- Ce qu’un banc d’essai doit contenir
- Les trois signaux à suivre
- Le minimum d’instrumentation
- Exemple concret : un agent de tri de support
- Comment décider : étendre, corriger ou arrêter
- Les erreurs les plus fréquentes
- Ce que cette méthode ne résout pas
- Prochaine action
- Sources officielles et liens utiles
Un agent peut donner une bonne impression pendant une démo et échouer dès qu’il reçoit des cas un peu sales, un peu ambigus ou un peu plus coûteux. Le problème n’est pas nouveau. C’est juste le même problème qu’en production logicielle, mais avec plus de variabilité et plus d’actions possibles.
La bonne question n’est donc pas seulement « est-ce qu’il répond bien ? ». La vraie question est plutôt : « comment savoir, de façon répétable, s’il mérite plus de périmètre, plus de données ou plus de pouvoir ? »
La réponse tient en trois couches.
- Un banc d’essai qui ressemble au terrain.
- Une observabilité qui montre ce qui se passe vraiment.
- Une règle d’arrêt qui tranche quand le signal est mauvais.
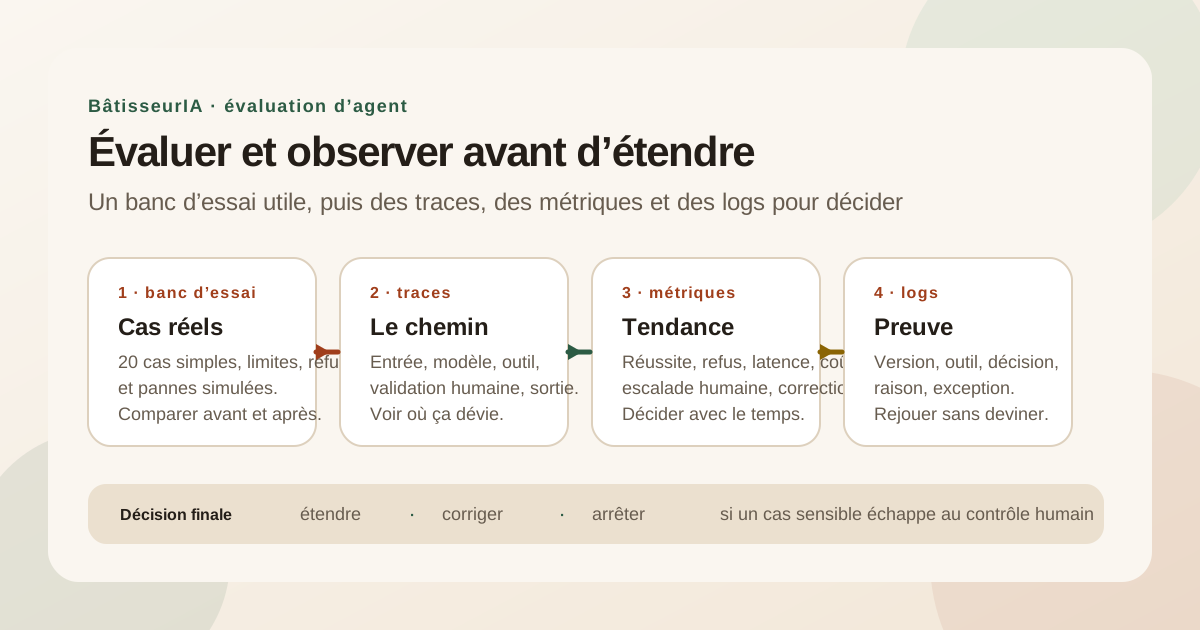
Schéma original BâtisseurIA, création interne 2026. Copyright BâtisseurIA / Aymane Abdennour. Licence : tous droits réservés.
À la fin de cet article, vous saurez construire un petit jeu de tests, lire les signaux qui comptent et décider si votre agent doit être étendu, corrigé ou arrêté.
Pourquoi une démo ne suffit pas
Une démonstration montre que quelque chose peut fonctionner. Elle ne montre pas si cela fonctionne souvent, sur des cas variés, sous charge, avec des erreurs d’entrée, ni si l’agent prend des raccourcis invisibles.
OpenTelemetry rappelle qu’un système observable doit être instrumenté et qu’une bonne observabilité repose sur des traces, des métriques et des logs. Autrement dit, si vous ne voyez que la réponse finale, vous voyez trop peu pour comprendre ce qui a réellement produit cette réponse.
Anthropic insiste sur un autre point : des évaluations utiles empêchent les équipes de rester dans une boucle réactive, où l’on découvre les problèmes seulement en production. Les évaluations doivent faire apparaître les changements de comportement avant qu’ils n’atteignent les utilisateurs.
La conséquence pratique est simple. Un agent n’est pas prêt parce qu’il a déjà produit une sortie plausible une fois. Il est prêt quand vous pouvez expliquer, rejouer et comparer ses résultats.
Ce qu’un banc d’essai doit contenir
Le meilleur banc d’essai ne cherche pas la perfection académique. Il cherche la variété utile.
Commencez avec une vingtaine de cas réels ou très proches du réel. Anthropic recommande de commencer avec une petite collection de tâches simples tirées des comportements attendus et des échecs réels. Microsoft conseille aussi de traiter l’évaluation comme un processus itératif qui commence très tôt et continue après le déploiement.
En pratique, répartissez vos cas en quatre familles.
- Cas normaux, où l’agent doit réussir sans hésiter.
- Cas limites, où l’entrée est incomplète, confuse ou mal rédigée.
- Cas de refus, où l’agent doit dire non ou demander une reprise humaine.
- Cas de panne, où un outil, une API ou une donnée de référence n’est pas disponible.
Chaque ligne de test doit garder les mêmes éléments :
- une entrée anonymisée ;
- une sortie attendue ;
- une action autorisée ;
- une preuve à conserver ;
- un critère de réussite ;
- un motif d’échec clair.
Le but n’est pas de faire joli dans un tableur. Le but est de savoir si l’agent garde la même discipline quand le contexte change.
Les trois signaux à suivre
Traces
Les traces montrent le chemin suivi par une requête à travers un système. Pour un agent, cela veut dire que vous voyez la suite des étapes : lecture de l’entrée, appel au modèle, récupération d’un document, usage d’un outil, validation humaine, sortie finale.
Sans traces, vous avez une boîte noire. Avec traces, vous pouvez répondre à la question la plus utile quand quelque chose casse : où le flux a-t-il divergé ?
Le guide OpenTelemetry sur l’observabilité des agents insiste sur la même logique. Si un agent s’appuie sur plusieurs composants, il faut des signaux standardisés pour comparer les comportements et corréler les étapes.
Métriques
Les métriques résument une tendance. Elles ne racontent pas tout, mais elles disent si le système s’améliore ou se dégrade.
Pour un premier agent, gardez peu d’indicateurs :
- taux de réussite sur les cas attendus ;
- taux de refus correct sur les cas hors périmètre ;
- taux d’escalade vers un humain ;
- latence moyenne ;
- coût moyen par tâche utile ;
- nombre d’erreurs sur outils ou données ;
- part des sorties corrigées par un humain.
n8n recommande de mesurer des aspects comme la correction, la similarité ou la pertinence selon le cas, mais aussi la vérification des outils utilisés quand l’agent appelle des actions. C’est la bonne logique : ne pas confondre un score général avec la qualité d’un comportement critique.
Logs
Les logs enregistrent ce qui s’est passé à un moment précis. Ils sont plus bruts que les métriques et plus locaux que les traces. Ils servent à reconstituer une décision, à comprendre une erreur et à documenter une exception.
Dans un agent, un bon log dit au minimum :
- quelle version du flux a tourné ;
- quel utilisateur ou quelle session a déclenché l’exécution ;
- quels outils ont été appelés ;
- quelle décision a été prise ;
- quelle exception a été signalée ;
- quelle action humaine a validé ou refusé la suite.
Sans cela, un log devient juste du bruit supplémentaire.
Le minimum d’instrumentation
Si vous partez d’un workflow n8n ou d’un orchestrateur similaire, la base la plus utile ressemble à ceci.
- Activer des traces sur les exécutions de workflow et de nœud.
- Exposer les endpoints de santé et de métriques.
- Journaliser les appels d’outils, les refus et les reprises humaines.
- Garder une collection de tests réutilisables.
- Relancer la même série après chaque modification.
n8n documente cette logique avec des guides sur les évaluations, les métriques, la journalisation, les traces OpenTelemetry et le suivi de santé via /healthz, /readiness et /metrics. L’idée n’est pas de multiplier les tableaux de bord. L’idée est de faire remonter ce qui permet vraiment une décision.
Le point clé est là : on teste d’abord hors production, puis on observe en production limitée, puis on compare les deux. Les changements de modèle, de prompt, de logique ou d’outil doivent toujours repasser par la même boucle.
Exemple concret : un agent de tri de support
Prenons un agent qui lit des messages entrants et prépare un brouillon de réponse.
Son périmètre utile peut être très simple :
- classer le message ;
- résumer la demande ;
- préparer une réponse courte ;
- proposer une escalade humaine si nécessaire.
Ce qu’il ne doit pas faire seul :
- fermer un ticket ;
- modifier un dossier client ;
- envoyer un message externe sans validation ;
- déclencher un remboursement ;
- supprimer une donnée.
Pour ce cas, vos tests peuvent mesurer :
- si la bonne catégorie est choisie ;
- si les refus sont propres ;
- si la demande d’escalade arrive au bon moment ;
- si le brouillon reste exploitable ;
- si le coût par message reste acceptable ;
- si la latence ne casse pas l’expérience.
La trace vous dira si l’agent a tenté un détour inutile. La métrique vous dira si ce détour arrive souvent. Le log vous dira pourquoi l’exception a été prise.
Si votre support est multilingue, ajoutez aussi des variantes de langue et de registre. Une équipe francophone en France n’utilise pas toujours les mêmes formulations qu’une équipe en Afrique francophone, et l’agent doit apprendre à reconnaître ces différences sans les transformer en erreurs de classement.
Comment décider : étendre, corriger ou arrêter
Ne cherchez pas un score magique. Cherchez une décision propre.
Vous pouvez étendre si :
- les cas normaux passent de façon stable ;
- les refus sont corrects ;
- les cas limites déclenchent une reprise humaine ;
- les coûts et la latence restent dans une zone acceptable ;
- les logs et les traces permettent de rejouer une erreur.
Vous devez corriger si :
- la réponse est bonne mais trop lente ;
- le refus est correct mais mal expliqué ;
- l’agent appelle un outil qu’il ne devrait pas appeler ;
- une partie des cas simples nécessite trop de reprise humaine.
Vous devez arrêter si :
- un cas irréversible échappe au contrôle humain ;
- une erreur de raisonnement touche un paiement, une publication ou une suppression ;
- les tests s’améliorent artificiellement mais la production se dégrade ;
- vous ne pouvez pas expliquer la décision avec les signaux disponibles.
Une moyenne n’est pas une garantie. Un bon score global peut cacher un cas grave. C’est pour cela qu’il faut garder les cas à fort impact dans la suite de tests, même s’ils sont rares.
Les erreurs les plus fréquentes
La première erreur consiste à mesurer seulement le taux de bonnes réponses.
Un agent peut répondre juste et agir mal. Il peut aussi refuser correctement mais perdre trop de temps. La qualité d’un agent de production ne se résume pas à la pertinence du texte produit.
La deuxième erreur consiste à ne pas tester les refus.
Si l’agent ne sait pas dire non, vous n’avez pas un agent utile. Vous avez un générateur d’actions risquées.
La troisième erreur consiste à changer le prompt sans rejouer le même banc d’essai.
Sans comparaison avant et après, vous ne savez pas si vous avez amélioré le système ou déplacé le problème.
La quatrième erreur consiste à ignorer le coût et la latence.
Une solution peut être correcte mais trop lente ou trop chère pour un usage réel. Les métriques d’exécution comptent autant que la qualité de la sortie.
La cinquième erreur consiste à laisser les logs exposer des secrets ou des données inutiles.
Un bon journal d’audit doit aider à comprendre, pas à créer un autre risque.
Ce que cette méthode ne résout pas
Cette approche ne remplace pas un audit de sécurité, une revue juridique, une politique de données ou un cadrage métier.
Elle ne garantit pas qu’un agent soit conforme, seulement qu’il est mieux observé et mieux testé.
Elle ne supprime pas le besoin d’un humain pour les décisions sensibles.
Elle ne rend pas une architecture fragile plus solide par magie. Si le modèle, les outils ou les permissions sont mauvais, l’observabilité vous aidera à le voir plus vite, pas à le sauver.
Prochaine action
Si vous avez déjà un prototype, faites ceci aujourd’hui.
- Choisissez un seul agent.
- Rassemblez 20 cas réels ou proches du réel.
- Ajoutez une colonne pour les traces, une pour les métriques et une pour les logs.
- Définissez une règle d’arrêt claire.
- Rejouez le même banc d’essai après la prochaine modification.
Si votre équipe utilise n8n ou un autre orchestrateur, gardez la même logique : évaluation hors production, observation limitée en production, puis décision. Si vous pouvez expliquer ce qui se passe quand tout va bien et quand tout déraille, vous êtes déjà beaucoup plus proche d’un agent exploitable.
Le meilleur signe de maturité n’est pas qu’un agent parle bien. C’est que vous sachiez prouver, avec quelques signaux simples, pourquoi il doit continuer, être corrigé ou s’arrêter.
Sources officielles et liens utiles
- OpenTelemetry, Observability primer : https://opentelemetry.io/docs/concepts/observability-primer/
- OpenTelemetry, AI Agent Observability: Evolving Standards and Best Practices : https://opentelemetry.io/blog/2025/ai-agent-observability/
- n8n, Test and improve AI workflows : https://docs.n8n.io/build/integrate-ai/test-and-improve-ai-workflows/
- n8n, Understand why to test : https://docs.n8n.io/build/integrate-ai/test-and-improve-ai-workflows/understand-why-to-test
- n8n, Run quick evaluations : https://docs.n8n.io/build/integrate-ai/test-and-improve-ai-workflows/run-quick-evaluations
- n8n, Use metrics to measure quality : https://docs.n8n.io/build/integrate-ai/test-and-improve-ai-workflows/use-metrics-to-measure-quality
- n8n, Trace executions with OpenTelemetry : https://docs.n8n.io/deploy/host-n8n/keep-n8n-running/trace-executions-with-opentelemetry
- n8n, Monitor n8n : https://docs.n8n.io/deploy/host-n8n/keep-n8n-running/monitor-n8n
- n8n, Set up logging : https://docs.n8n.io/deploy/host-n8n/keep-n8n-running/set-up-logging
- Anthropic, Demystifying evals for AI agents : https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Microsoft Learn, Review the agent evaluation checklist : https://learn.microsoft.com/en-us/agents/agent-evaluation/evaluation-checklist
- Article lié : Agent IA en production : identité dédiée, sandbox et approbation avant le premier outil
- Article lié : Choisir un seul cas d’usage IA rentable et mesurable
- Page liée : Automatisation