Avant d’adopter une solution IA, exigez trois preuves
Une méthode pour comparer un copilote, un agent ou un workflow sur vos cas réels, avant de signer ou de déployer.
Sommaire
- Pourquoi la démo ne suffit pas
- Première preuve : vos cas réels, pas les cas propres du vendeur
- Deuxième preuve : le mode ombre
- Troisième preuve : la production limitée avec observabilité
- Adapter le test au terrain France et Afrique francophone
- Le seuil d’arrêt se fixe avant l’achat
- Exemple simple pour une petite équipe
- Ce qu’il faut refuser sans regret
- Votre protocole en une heure
- Sources officielles et liens utiles
Une démo vend une impression. Une preuve réduit une incertitude.
Quand on vous montre un copilote, un agent ou un workflow d’IA, le vrai sujet n’est pas seulement de savoir s’il répond bien sur trois exemples propres. Le sujet est plus simple et plus exigeant à la fois : est-ce qu’il tient vos cas réels, dans votre contexte, avec vos contraintes, sans vous enfermer dans un système impossible à arrêter ?
France Num a publié en 2026 un catalogue d’offres IA pour PME et ETI. Le signal est clair : l’offre se structure, les solutions se multiplient, et les petites organisations ont maintenant plus de choix qu’avant. Le problème n’est donc plus seulement de trouver une solution. C’est de choisir celle que l’on peut vraiment vérifier.
Mon interprétation des sources récentes de France Num, de la CNIL, de n8n, du World Bank Group et de l’UNESCO est simple : avant de signer, il faut exiger trois preuves. Une preuve hors ligne, une preuve en conditions réelles sans effet de bord, puis une preuve de production avec observabilité et sortie de secours.
À la fin de cet article, vous saurez comparer une solution IA sans vous laisser hypnotiser par la démonstration commerciale, décider si elle mérite un pilote, et fixer un seuil d’arrêt avant qu’elle touche un vrai flux.
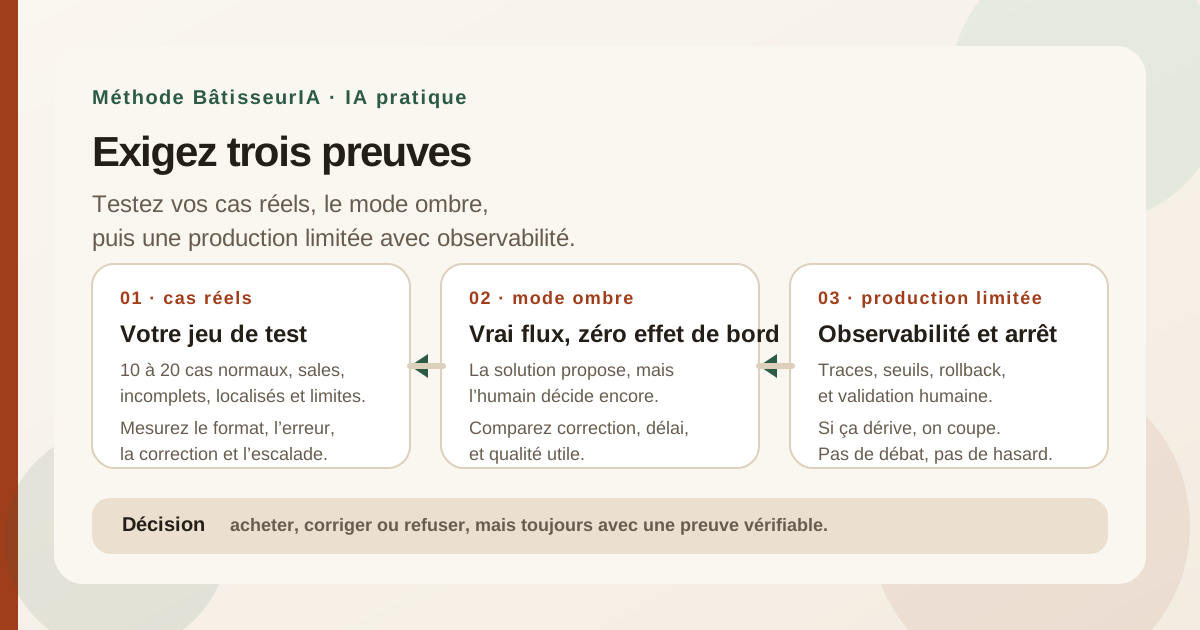
Schéma original BâtisseurIA. Création interne 2026. Copyright BâtisseurIA / Aymane Abdennour. Licence : tous droits réservés.
Pourquoi la démo ne suffit pas
Le catalogue rassure, la démo convainc, puis le projet déraille dans les cas un peu sales.
Le baromètre France Num 2025, mis à jour le 30 juillet 2026, montre bien que l’adoption existe déjà, mais qu’elle reste inégale et souvent incomplète. 26 % des TPE et PME déclarent utiliser une solution d’IA, 22 % utilisent de l’IA générative, 14 % des chatbots ou assistants, et seulement 5 % automatisent des tâches. L’outil arrive donc plus vite que la méthode de validation.
Le même constat ressort du côté d’Afnic : 61 % des TPE et PME ne surveillent pas ou pas vraiment les performances de leurs actions d’acquisition et de fidélisation sur internet. Autrement dit, beaucoup d’organisations savent déjà acheter, publier ou tester une solution, mais pas toujours la mesurer correctement ensuite.
Ma conclusion est une inférence, pas un fait brut : si vous achetez une solution IA sans protocole de preuve, vous n’achetez pas de la performance. Vous achetez une promesse.
Première preuve : vos cas réels, pas les cas propres du vendeur
La première chose à tester n’est pas le modèle. C’est la tâche.
Avant toute comparaison, écrivez noir sur blanc le résultat attendu. Par exemple :
- trier une demande entrante ;
- résumer un document ;
- préparer un brouillon de réponse ;
- extraire des champs d’une facture ;
- classer un ticket selon un type de besoin ;
- proposer un premier rapprochement.
Ensuite, construisez un petit jeu de cas représentatif. Dix à vingt cas suffisent pour commencer, à condition qu’ils ne soient pas tous jolis. Mélangez volontairement :
- des cas normaux ;
- des cas incomplets ;
- des doublons ;
- des documents mal scannés ;
- des demandes ambiguës ;
- des entrées trop longues ;
- des cas avec une langue locale ou un mélange de langues ;
- des cas qui contiennent une consigne trompeuse ou hors sujet ;
- des cas où un champ clé manque ;
- des cas où la bonne réponse est de refuser ou d’escalader.
Ce jeu de test doit être le vôtre. Une solution qui réussit sur un jeu générique mais échoue sur vos formulaires, vos emails, vos PDF ou vos règles métier n’est pas une solution prête.
Pour le juger correctement, utilisez d’abord des critères déterministes. Est-ce que le résultat contient les champs demandés ? Est-ce que le format est correct ? Est-ce que les valeurs interdites sont absentes ? Est-ce que la solution évite d’inventer une action qui n’était pas autorisée ?
n8n recommande justement d’associer plusieurs méthodes d’évaluation, avec des checks déterministes pour les critères objectifs, un juge modèle pour certaines qualités subjectives, et une revue humaine pour les cas sensibles. C’est la bonne hiérarchie. Le score automatique ne doit pas masquer un défaut de fond.
Ce qu’il faut regarder pendant ce test
Notez au minimum :
- le taux de réussite sur les cas normaux ;
- le taux d’échec sur les cas limites ;
- le nombre d’erreurs critiques ;
- le nombre de corrections manuelles nécessaires ;
- le temps pris pour produire quelque chose d’exploitable ;
- la fréquence des réponses inventées ou trop confiantes.
Si la solution doit toucher des données sensibles, la note exploratoire de la CNIL sur l’IA agentique rappelle un point essentiel : plus les systèmes interagissent avec plusieurs services et mémorisent des échanges, plus les chaînes de traitement deviennent complexes et difficiles à suivre. Le test hors ligne doit donc vérifier aussi la circulation des données, pas seulement la qualité du texte.
Deuxième preuve : le mode ombre
Le mode ombre consiste à faire tourner la solution sur de vrais flux sans lui laisser l’action finale.
Par exemple, elle peut :
- lire un ticket réel ;
- proposer une catégorie ;
- générer un brouillon ;
- suggérer un prochain pas ;
- mais laisser un humain décider de l’envoi, de la modification, du rapprochement ou du rejet.
Ce mode est précieux parce qu’il rapproche le test du réel sans vous exposer au risque complet. Il montre si la solution tient quand les cas ne sont plus propres, quand les pièces se répètent, quand les demandes arrivent de plusieurs canaux, ou quand l’outil manque une information.
Dans ce mode, comparez la solution à votre traitement humain de référence. Posez-vous quatre questions :
- la solution accélère-t-elle vraiment la première réponse ;
- réduit-elle les corrections ;
- augmente-t-elle les escalades inutiles ;
- produit-elle un biais de confiance, c’est-à-dire des réponses qui paraissent bonnes mais cachent une mauvaise interprétation ?
Le mode ombre est aussi l’endroit où l’on détecte un vrai problème de gouvernance. Si une solution demande déjà trop de permissions, trop de mémoire ou trop de données au stade d’observation, ce n’est probablement pas un simple pilote.
La CNIL et le CIANum insistent sur le risque de perte de maîtrise quand les flux de données deviennent opaques. En pratique, cela veut dire que vous devez pouvoir expliquer où passe l’information, ce qui est conservé, ce qui est oublié et ce qui peut être effacé.
Troisième preuve : la production limitée avec observabilité
Si les deux premières preuves sont solides, vous pouvez envisager une production très limitée.
Cette étape n’a rien d’un feu vert général. Elle ressemble plutôt à une zone de sécurité :
- un périmètre réduit ;
- une population limitée ;
- un volume plafonné ;
- une validation humaine encore présente ;
- un retour arrière simple ;
- des journaux lisibles ;
- et un arrêt immédiat si le comportement se dégrade.
n8n, dans son guide sur l’observabilité des agents, explique qu’il faut capturer toute l’exécution d’un agent, y compris les appels de modèle, les appels d’outils et les interactions avec les systèmes externes. C’est exactement le bon réflexe. Sans traces, vous n’expliquez pas les écarts. Sans traces, vous ne pouvez ni diagnostiquer ni corriger.
Pour cette phase, surveillez des indicateurs qui parlent à la fois au métier et à l’exploitation :
- taux de réussite sur les cas ciblés ;
- part des sorties corrigées par un humain ;
- délai moyen avant détection d’un écart ;
- nombre de fois où le système a dû revenir en manuel ;
- coût par dossier ou par interaction ;
- fréquence des échecs critiques.
NIST, avec son initiative dédiée aux standards pour les agents IA, insiste sur des systèmes sûrs, interopérables et dignes de confiance. En langage de terrain, cela veut dire que la solution doit pouvoir être observée, pilotée, contenue et arrêtée. Si un vendeur ne sait pas vous montrer ses journaux, ses limites de permission ou son comportement en cas d’échec, il vous demande de lui faire confiance à l’aveugle.
Adapter le test au terrain France et Afrique francophone
Un bon test est toujours local.
Le World Bank Group souligne, dans son rapport 2025 sur les fondations de l’IA, que les pays à revenu faible et intermédiaire font face à de fortes difficultés pour adopter ou déployer l’IA à grande échelle. La bonne réponse n’est pas de copier un modèle unique, mais d’adapter les fondations, les compétences et les usages à la réalité locale.
UNESCO ajoute un point très concret : les cadres de compétences IA et les ressources en langues locales comptent pour l’inclusion et l’adoption. Pour une équipe en France, au Sénégal, au Maroc, en Côte d’Ivoire, au Bénin ou ailleurs en Afrique francophone, cela change le protocole de test.
Concrètement, vérifiez aussi :
- les entrées en français simple ;
- les entrées en français administratif ;
- les mélanges de langues courants dans votre contexte ;
- les documents photo, scannés ou compressés ;
- la qualité réseau minimale ;
- le comportement sur mobile ;
- le niveau de dépendance à une connexion continue ;
- la possibilité de revenir à un traitement humain si la liaison tombe.
Si votre solution ne fonctionne qu’avec un excellent réseau, des données propres et des utilisateurs très formés, elle n’est pas forcément mauvaise. Elle est peut-être juste mal adaptée à votre terrain.
Le seuil d’arrêt se fixe avant l’achat
Le piège, avec les solutions IA, c’est de repousser la décision jusqu’après le premier incident.
Je vous conseille l’inverse : écrivez votre seuil d’arrêt avant le pilote.
Exemples de seuils utiles :
- une erreur critique sur un cas sensible suffit à arrêter ;
- trois corrections humaines consécutives sur la même catégorie imposent une revue ;
- une absence de journal exploitable bloque le déploiement ;
- une perte de contrôle des permissions suspend l’essai ;
- une dérive de coût ou de délai remet la décision à plat.
Le but n’est pas de tuer le projet au moindre défaut. Le but est d’empêcher qu’un système fragile gagne du terrain parce qu’il semble performant sur les bons cas et invisible sur les mauvais.
Si vous devez choisir entre une solution spectaculaire et une solution mesurable, choisissez la mesurable. Une solution mesurable peut s’améliorer. Une solution spectaculaire peut juste mieux vous impressionner.
Exemple simple pour une petite équipe
Imaginons une équipe qui veut acheter une solution IA pour classer des demandes entrantes.
Le vendeur montre une belle démo. Elle fonctionne sur quatre mails bien rédigés. La suite sérieuse ressemble à ceci :
- l’équipe extrait 15 messages réels, anonymisés ;
- elle ajoute 5 cas pénibles, dont des doublons et des messages incomplets ;
- elle lance un test hors ligne avec des règles déterministes ;
- elle compare ensuite la solution à la main sur un flux réel en mode ombre ;
- elle active un pilote limité seulement si les erreurs critiques sont nulles ou maîtrisées ;
- elle suit pendant une semaine le taux d’escalade, les corrections et le temps gagné ;
- elle coupe le pilote si les résultats se dégradent.
Le gain n’est pas seulement d’éviter un mauvais achat. Le gain est aussi de mieux rédiger la demande, mieux choisir le périmètre et mieux comprendre ce que l’organisation attend vraiment d’une IA.
Ce qu’il faut refuser sans regret
Refusez la solution si le vendeur ne peut pas :
- tester sur vos cas ou sur un jeu représentatif ;
- expliquer ses limites de façon claire ;
- documenter les permissions et les flux de données ;
- fournir des logs ou des traces utiles ;
- proposer un vrai mode de retour arrière ;
- distinguer ce qui est automatique de ce qui doit rester humain.
Ce refus n’est pas un manque d’audace. C’est une forme de discipline. Une organisation qui sait dire non à une mauvaise preuve gagne souvent du temps, du budget et de la crédibilité.
Votre protocole en une heure
Si vous devez prendre une décision rapidement, faites ceci :
- définissez un seul cas d’usage ;
- préparez 10 à 20 cas réels ou représentatifs ;
- fixez vos critères déterministes ;
- lancez un test hors ligne ;
- passez en mode ombre ;
- mesurez une semaine de production limitée ;
- écrivez vos seuils d’arrêt avant d’ouvrir le budget.
Vous n’avez pas besoin d’un grand plan pour commencer. Vous avez besoin d’un petit protocole qui vous empêche de vous tromper vite.
Quand ce protocole est clair, vous pouvez ensuite approfondir le passage en production avec la fiche de délégation d’un agent IA et l’article sur l’identité, le sandbox et l’approbation avant production. Si votre problème de départ est plutôt la file d’attente et la réponse à un flux entrant, Visibilité, réponse, mesure reste une bonne base.
Sources officielles et liens utiles
- France Num, solutions d’IA pour PME et ETI
- France Num, Baromètre France Num 2025
- Afnic, Réussir avec le web 2025
- n8n, How to evaluate the performance of AI agents
- n8n, Building AI Agent Observability for Production Workflows
- CNIL, IA agentique et données personnelles
- NIST, AI Agent Standards Initiative
- World Bank, Digital Progress and Trends Report 2025: Strengthening AI Foundations
- UNESCO, AI competency frameworks and local language learning in Africa
Dernière vérification des sources : 17 août 2026. Méthode générale, pas un avis juridique, comptable ou de sécurité.