Automatisation IA : éviter les doublons avant de laisser agir le workflow
Une méthode pratique pour rendre une action répétable sans double envoi, double création ou double paiement quand un workflow IA doit être relancé.
Sommaire
Un workflow peut échouer sans que son action ait échoué.
La requête part. Le service externe traite la demande. Puis la connexion coupe avant que votre automatisation reçoive la réponse. Le système voit un timeout et recommence. Vous obtenez alors deux tickets, deux messages, deux lignes comptables ou deux paiements, alors que le déclencheur n’a eu lieu qu’une fois.
Le risque augmente avec l’IA parce qu’un modèle peut choisir un outil, reformuler une demande ou relancer une étape. La fluidité de la démonstration masque parfois une question plus importante : que se passe-t-il si la même intention arrive deux fois, presque en même temps ?
À la fin de ce guide, vous saurez remplir une fiche d’idempotence en 30 minutes, choisir une clé de déduplication, séparer les actions rejouables des actions à confirmer et tester le cas le plus trompeur : la réponse perdue après une action réussie.
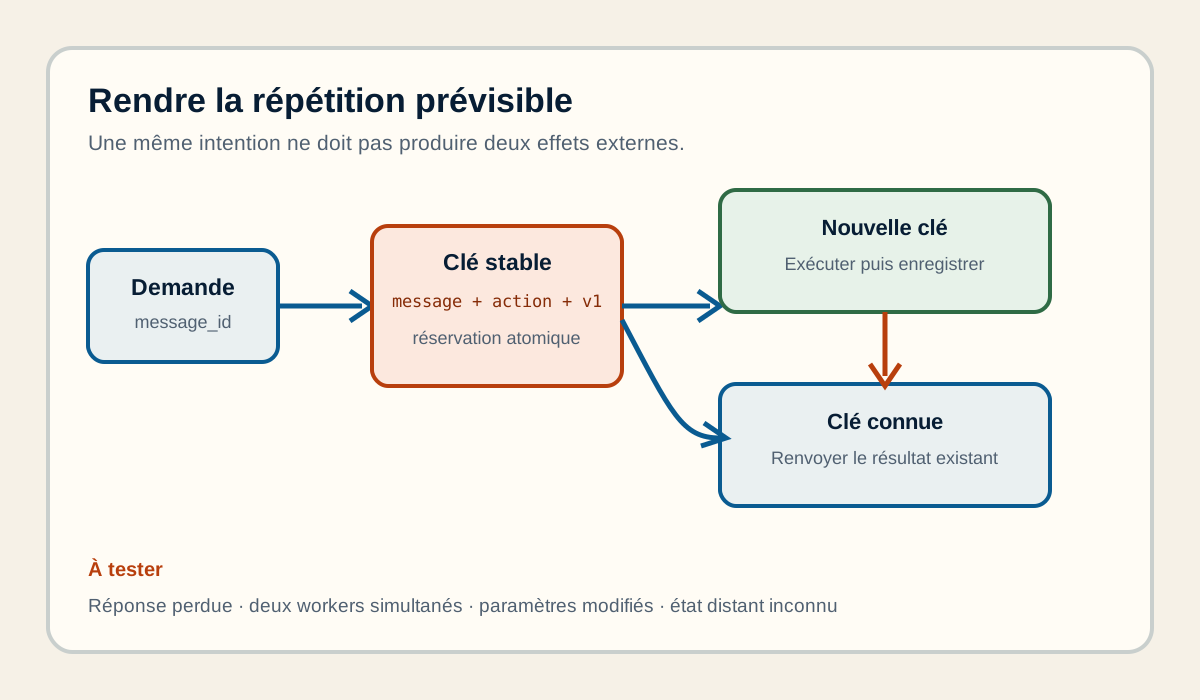
Schéma original BâtisseurIA, créé pour cet article en 2026. Crédit : BâtisseurIA / Aymane Abdennour. Licence : CC BY 4.0.
Un retry n’est pas une nouvelle demande
Un retry est une nouvelle tentative technique pour obtenir le résultat d’une demande déjà formulée. Il peut être déclenché par une coupure réseau, un délai dépassé, une erreur temporaire ou un redémarrage du worker. Le système distant, lui, ne sait pas forcément qu’il s’agit d’une tentative.
La distinction est essentielle :
- Une lecture peut généralement être répétée sans modifier la donnée.
- Une mise à jour complète peut être conçue pour produire le même état final.
- Une création, un envoi ou un débit peut produire un nouvel effet à chaque appel.
La RFC 9110 sur HTTP définit l’idempotence par l’effet attendu côté serveur : plusieurs requêtes identiques doivent avoir le même effet qu’une seule. Elle précise aussi qu’un client ne devrait pas relancer automatiquement une requête non idempotente sans mécanisme permettant de savoir qu’elle n’a pas déjà été appliquée.
Cela ne signifie pas que POST est toujours dangereux ou que PUT est toujours sûr. Cela signifie que la propriété doit être définie pour l’opération métier réelle. « Créer une facture » n’est pas la même chose que « mettre à jour la facture 2026-0042 avec cet état ».
La fiche d’idempotence en sept questions
Avant de connecter un agent ou un workflow à un outil réel, écrivez une fiche courte. Elle sert à rendre les hypothèses visibles pour la personne qui construit, teste ou reprend le flux.
1. Quelle est l’action exacte ?
Écrivez un verbe et une cible : créer un ticket, envoyer un message, réserver un créneau, ajouter une ligne, générer un brouillon. Évitez « traiter la demande », qui mélange souvent plusieurs effets.
Une action qui contient trois effets doit être découpée. Sinon, vous ne saurez pas quel résultat a déjà été produit lorsque l’étape suivante échoue.
2. Quel est l’identifiant stable de l’intention ?
La clé doit représenter le même événement métier, pas le numéro de tentative. Un identifiant utile peut combiner commande_id, action et version, par exemple commande-1842-confirmation-v1.
N’utilisez pas l’heure courante seule. Deux tentatives recevraient deux clés et la déduplication deviendrait impossible. N’utilisez pas non plus le texte libre produit par le modèle : une reformulation ne doit pas créer une nouvelle action.
3. Où la clé est-elle conservée ?
Il faut une mémoire consultable par les exécutions concurrentes. Elle peut vivre dans la base du système métier, une table dédiée ou le service qui reçoit la requête. Notez la durée de conservation et le lien avec le résultat : statut, identifiant distant, horodatage et empreinte des paramètres pertinents.
Le point important est l’opération atomique. Deux workers ne doivent pas pouvoir lire « clé absente » puis exécuter tous les deux. L’enregistrement de la clé et la prise du verrou doivent être protégés par une contrainte unique, une transaction ou une primitive équivalente.
4. Que renvoie une répétition ?
Une répétition ne doit pas seulement répondre « déjà fait ». Elle doit retourner le résultat connu, ou un état explicite si la première tentative est encore en cours. C’est le principe documenté par Stripe pour ses requêtes idempotentes : une même clé permet de rejouer une demande après une erreur de connexion sans créer un second objet.
Prévoyez au moins quatre états : nouvelle, en cours, réussie, échouée-rejouable. Une erreur définitive ne doit pas être masquée par un simple « déjà traité ».
5. Que se passe-t-il si les paramètres changent ?
Une clé ne doit pas être réutilisée pour une intention différente. Si la même clé revient avec un montant, un destinataire ou une version différente, le système doit refuser et signaler un conflit.
Cette vérification évite une confusion discrète : un client corrige une demande, mais le système lui renvoie le résultat d’une ancienne version parce que la clé est restée identique.
6. Quelle action reste humaine ?
L’idempotence ne valide pas la pertinence. Elle empêche surtout qu’une même décision technique produise plusieurs effets. Une IA peut classer un message et proposer une action. Une personne peut encore devoir confirmer un paiement, une suppression, une publication ou un engagement contractuel.
Écrivez donc la frontière : « Le workflow peut préparer et enregistrer un brouillon. L’envoi final exige une validation humaine. » Cette phrase est plus utile qu’un vague « supervision activée ».
7. Quel est le signal d’arrêt ?
Arrêtez le flux si la clé est incohérente, si le résultat distant est inconnu, si une étape non idempotente a été exécutée sans preuve ou si le nombre de retries dépasse le budget prévu. La documentation Google SRE sur les retries rappelle qu’un retry mal contrôlé peut amplifier une surcharge et créer une boucle de défaillances.
Trois protections qui se complètent
Une clé d’idempotence ne résout pas toutes les formes de doublons. Il faut distinguer trois niveaux.
La clé d’idempotence
Elle répond à : « Est-ce la même intention rejouée ? » Le récepteur mémorise la clé et le résultat. C’est la meilleure protection lorsque le même appel peut être répété après une coupure.
La contrainte métier
Elle répond à : « Peut-il exister deux objets équivalents ? » Une base peut imposer une unicité sur commande_id + type_document, ou un système peut refuser un second ticket ouvert pour le même événement. Cette règle reste utile si deux clés différentes sont générées par erreur.
La validation de cohérence
Elle répond à : « L’état reçu correspond-il à ce qui existe déjà ? » Avant d’écraser une donnée, le workflow peut vérifier une version, un ETag ou une condition If-Match. Les guides Google Cloud sur les APIs HTTP rappellent que l’idempotence concerne l’effet côté serveur, tandis que la réponse et les conditions de mise à jour doivent être traitées séparément.
Ces protections ne sont pas interchangeables. Une clé est liée à une intention. Une contrainte protège le modèle métier. Une condition de version protège contre les modifications concurrentes.
Exemple : classer puis notifier une demande entrante
Prenons un workflow simple. Une demande arrive dans une boîte partagée. Un modèle extrait la catégorie et prépare une réponse. Le workflow crée ensuite un ticket et envoie une notification dans un canal interne.
Le mauvais design enchaîne directement les deux appels. Si la création du ticket réussit mais que la notification expire, le retry recrée le ticket.
Un design plus robuste sépare les preuves :
- Le message reçoit un identifiant stable, par exemple son identifiant de réception.
- La classification et ses paramètres sont enregistrées comme une proposition.
- Une clé
message_id + création-ticket + versionest réservée atomiquement. - Le ticket est créé ou retrouvé avec cette clé.
- L’identifiant du ticket est enregistré avant la notification.
- La notification possède sa propre clé, car elle est une action différente.
- En cas de retry, le workflow relit le ticket existant et ne recrée pas l’objet.
Cette séparation permet aussi de reprendre proprement. Si la notification reste incertaine, le ticket est visible et la personne responsable peut vérifier le canal avant de renvoyer le message.
Le test que les démonstrations oublient
Ne testez pas seulement un succès de bout en bout. Faites un test contrôlé avec des données sans conséquence et provoquez ces situations :
- Le premier appel expire côté client après traitement côté serveur.
- Deux workers arrivent simultanément avec la même clé.
- La même clé revient avec des paramètres différents.
- Le service distant répond cinq fois avec une erreur temporaire.
- Le workflow redémarre entre l’action distante et l’enregistrement du résultat.
- Une clé ancienne revient après l’expiration de sa durée de conservation.
Pour chaque cas, écrivez le résultat attendu avant de lancer le test : nombre d’objets créés, nombre de notifications, état de la clé, preuve conservée et décision humaine éventuelle. Un test passe si le système produit un résultat compréhensible, pas seulement un code HTTP favorable.
Le guide Google SRE sur les tâches périodiques donne un rappel utile : certaines tâches peuvent être relancées sans risque, d’autres, comme une diffusion, ne doivent pas être lancées deux fois. La bonne politique dépend de l’effet réel, pas du fait que l’appel soit automatisé.
Les limites à accepter
L’idempotence ne rend pas une action sûre par magie.
D’abord, une action externe peut être réellement inconnue. Si le service a traité la demande puis perdu sa réponse, votre système ne sait pas toujours si la clé a été enregistrée. Il faut alors interroger l’état distant, utiliser une opération de rapprochement ou arrêter pour vérification humaine. Relancer à l’aveugle est le choix le plus risqué.
Ensuite, la fenêtre de déduplication compte. Une clé conservée trop peu de temps peut laisser passer un doublon tardif. Une clé conservée indéfiniment peut bloquer une nouvelle intention légitime ou augmenter inutilement les données stockées. La durée doit suivre le risque métier et les règles de conservation applicables.
Enfin, une IA peut produire deux intentions différentes qui se ressemblent. La déduplication ne doit pas reposer sur une similarité sémantique opaque quand l’action est sensible. Pour un paiement, une suppression ou un message externe, utilisez un identifiant métier et une confirmation explicite.
La fiche à remplir aujourd’hui
Choisissez un seul workflow et complétez ces lignes :
- Action : quel effet externe produit-il ?
- Intention : quel identifiant stable suit cette demande ?
- Clé : comment est-elle construite et où est-elle unique ?
- Résultat : que renvoie une répétition ?
- Concurrence : quelle opération atomique empêche deux démarrages ?
- Limite : quel paramètre différent déclenche un conflit ?
- Humain : quelle action ne part jamais sans confirmation ?
- Arrêt : que fait-on quand l’état distant est inconnu ?
- Preuve : quels identifiants, statuts et horodatages sont conservés ?
Si vous ne pouvez pas remplir une ligne, le workflow n’est pas prêt à agir sur un système réel. Commencez par un mode brouillon, un environnement de test ou une opération réversible. Mesurez les doublons empêchés, les retries, les conflits de clé et les cas envoyés en vérification humaine.
L’objectif n’est pas de rendre chaque étape complexe. C’est de rendre la répétition prévisible. Un workflow fiable sait distinguer une nouvelle demande, une tentative identique et une situation inconnue. C’est cette distinction qui permet ensuite de décider, avec des preuves, s’il faut automatiser davantage.
Pour poursuivre, comparez cette fiche avec le runbook de reprise d’une automatisation IA et avec la fiche de délégation d’un agent IA. Si vous avez un projet défini, préparez son contexte, son résultat attendu et son état actuel avant de passer par la page contact.